- AI
- TypeScript
- Automation
Jev จาก TypeSafe คืออะไร? โมเดลที่ตัดสินใจแทน if-else ของคุณ
รู้จัก Jev โมเดล System One ของ TypeSafe ที่คืนคำตอบแบบ typed + ความน่าจะเป็น ไม่ใช่ข้อความยาว ๆ พร้อมโค้ด TypeScript และ 3 use case ที่ใช้ได้จริง
Jev จาก TypeSafe คืออะไร?
ทุกวันนี้เวลาเราอยาก “ให้ AI ตัดสินใจ” อะไรสักอย่างในระบบ — เช่น อีเมลฉบับนี้ควรเข้าคิวไหน, ลูกค้าคนนี้โกรธหรือยัง, agent ตัวนี้ควรกดปุ่มคืนเงินไหม — เรามักจะยิงไปหา LLM ตัวใหญ่ แล้วขอ JSON กลับมา จากนั้นก็มานั่ง parse, นั่ง retry, นั่งจ่ายค่า output token ทั้งที่จริง ๆ เราต้องการคำตอบแค่คำเดียว
Jev คือคำตอบของ TypeSafe ต่อปัญหานี้ครับ
Jev เป็นโมเดลแบบ System One (คิดเร็ว ตัดสินใจทันที ไม่ต้องคิดยาว) ที่ออกแบบมาเพื่อ “ตัดสินใจแบบมีขอบเขต” โดยเฉพาะ เราส่ง state (ข้อความหรือ JSON) กับ คำถามที่มี type เข้าไป แล้วได้ คำตอบที่มี type + ความน่าจะเป็น กลับมาให้โค้ดเอาไปใช้ต่อได้ตรง ๆ
วิธีคิดที่ง่ายที่สุดคือ: Jev คือ if statement ที่ฉลาดขึ้น — ไม่ใช่แชตบอท
มันทำงานยังไง
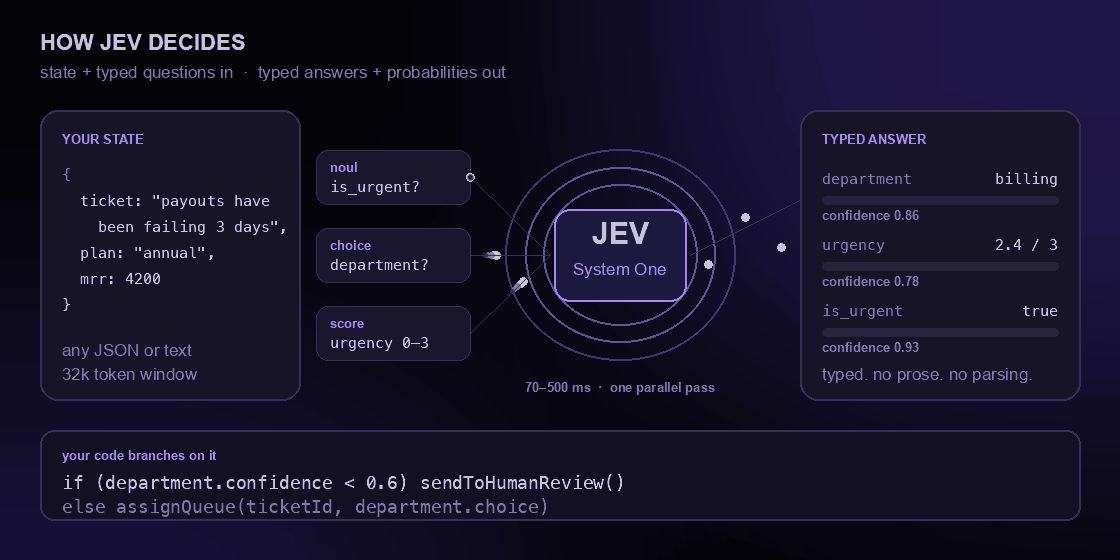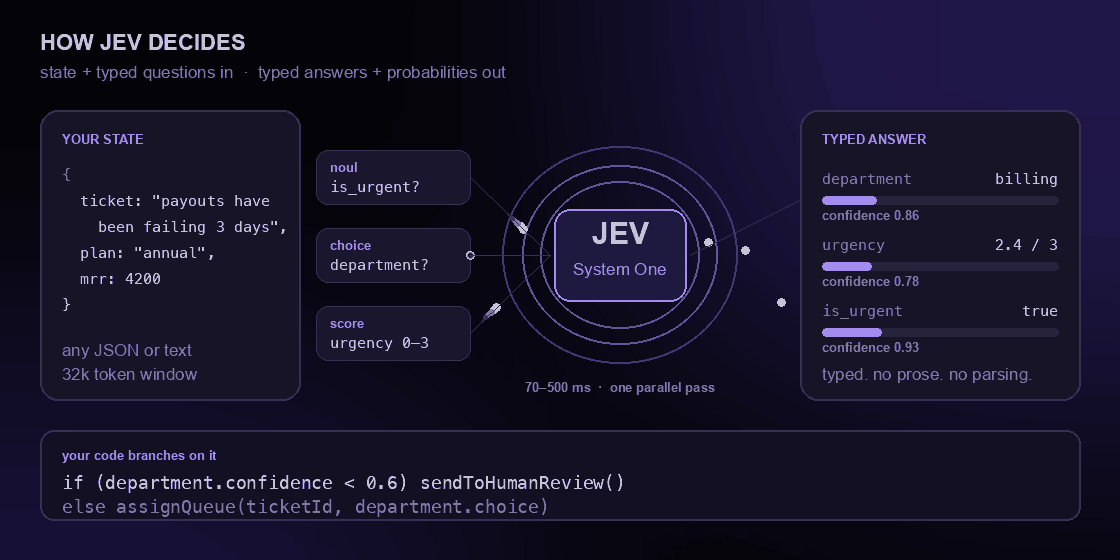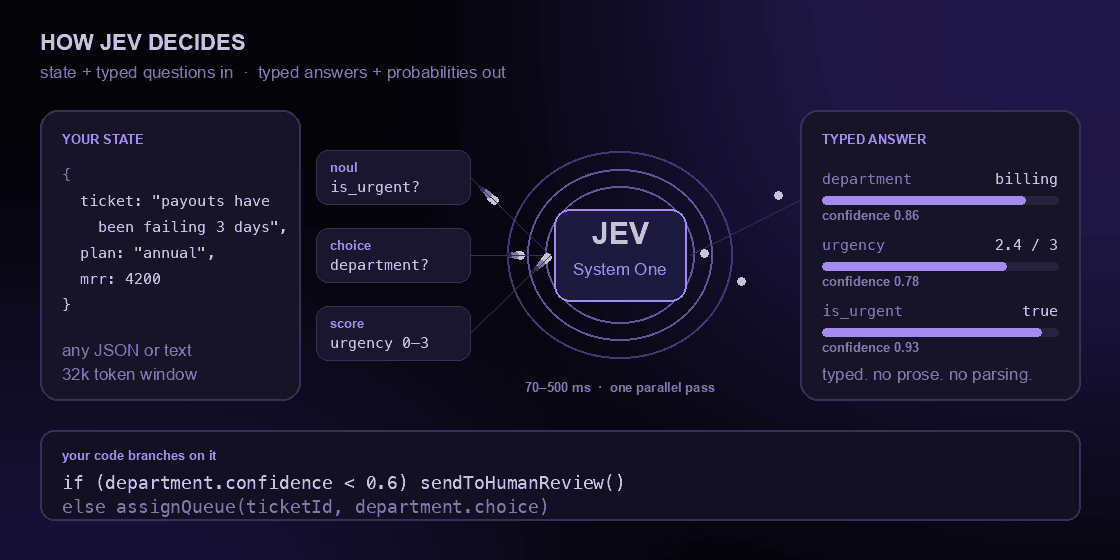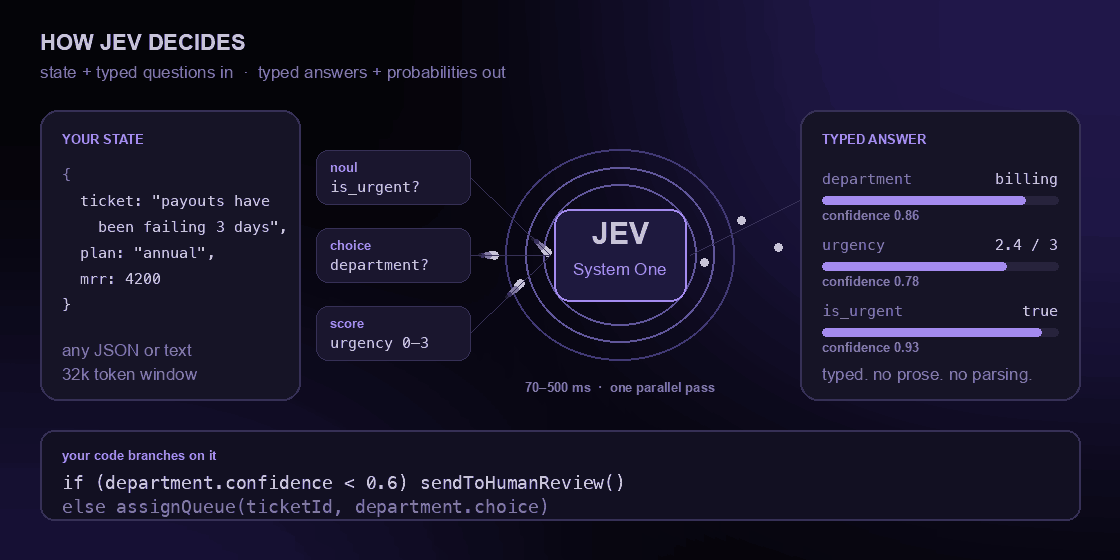
จุดสำคัญคือ Jev ไม่ generate ข้อความ มันคำนวณความน่าจะเป็นของคำตอบแบบขนานในรอบเดียว ทำให้เร็วและถูกกว่าการให้ LLM เขียนคำตอบออกมาเป็นประโยคมาก
คำถามที่ถามได้มี 3 แบบ:
| แบบ | ใช้ตอนไหน | ได้อะไรกลับมา |
|---|---|---|
noul | คำถามใช่/ไม่ใช่ | ค่า boolean + ความน่าจะเป็น |
choice | เลือก 1 จากหลายหมวด | key ที่เลือก + การกระจายความน่าจะเป็นทุกตัวเลือก |
score | ให้คะแนนบนสเกลที่เรานิยามเอง | คะแนนถ่วงน้ำหนัก + ความน่าจะเป็นแต่ละระดับ |
โค้ด TypeScript ตัวเต็ม
npm install @typesafe-ai/sdk     # ต้องการ Node.js 20 ขึ้นไป
export TYPESAFE_API_KEY="your-api-key"
⚠️ เก็บ API key ไว้ฝั่ง server เท่านั้น อย่าใส่ในโค้ดฝั่ง browser และอย่า commit ขึ้น repo
import { choice, noul, score, TypeSafeClient } from "@typesafe-ai/sdk";

const client = new TypeSafeClient();

const response = await client.systemOne({
  model: "jev-latest",
  state: { ticket: "จ่ายเงินไม่ผ่านมา 3 วันแล้ว ขอเงินคืนด้วย", plan: "annual" },
  questions: {
    department: choice("เรื่องนี้ควรเข้าทีมไหน จาก `ticket`?", {
      billing: "เรื่องการจ่ายเงิน คืนเงิน หรือ subscription",
      technical: "บั๊กของโปรดักต์ หรือปัญหา integration",
      account: "ล็อกอินไม่ได้ หรือปัญหาการเข้าถึงบัญชี",
      other: "ไม่เข้าพวกข้างบน",
    }),
    urgency: score("`ticket` นี้ด่วนแค่ไหน?", [
      "รอได้",
      "ควรดูเร็ว ๆ นี้",
      "ต้องดูวันนี้",
    ]),
    asksForRefund: noul("`ticket` ขอเงินคืนหรือเปล่า?"),
  },
});
SDK จะ infer type ของคำตอบให้จาก map ของคำถามเลย ไม่ต้อง cast เอง:
choice→.choice(key ที่เลือก),.probabilities,.confidencescore→.score(ตัวเลข),.confidencenoul→.noul(boolean),.confidence
คำถามทุกข้อในหนึ่ง request จะถูกประมวลผลแบบขนาน ถ้าต้องการ logic ที่ต่อเนื่องกัน (ถามข้อ 2 โดยอิงคำตอบข้อ 1) ต้องแยกเรียกใหม่พร้อม state ที่อัปเดตแล้ว
ตัวเลขที่ทำให้มันน่าสนใจ
- ความเร็ว: ตอบใน 70–500 มิลลิวินาที เพราะตอบทุกคำถามในรอบเดียวแบบขนาน
- ราคา: $0.042 ต่อ 1 ล้าน input token ส่วน output token ฟรี (คำนวณคร่าว ๆ ที่ 500 token ต่อข้อความ = ราว 47,000 ข้อความต่อ 1 ดอลลาร์)
- Context window: 32,000 token
- TypeSafe เคลมว่าเร็วกว่าและถูกกว่า LLM ทั่วไปมากในงาน classification
แปลเป็นภาษาธุรกิจ: งานคัดแยก/ให้คะแนนที่เมื่อก่อนต้องจ่ายค่า LLM ทุกครั้ง ตอนนี้ถูกลงจนใส่ไว้ใน hot path ของระบบได้เลย
3 Use Case ที่เอาไปใช้ได้จริง
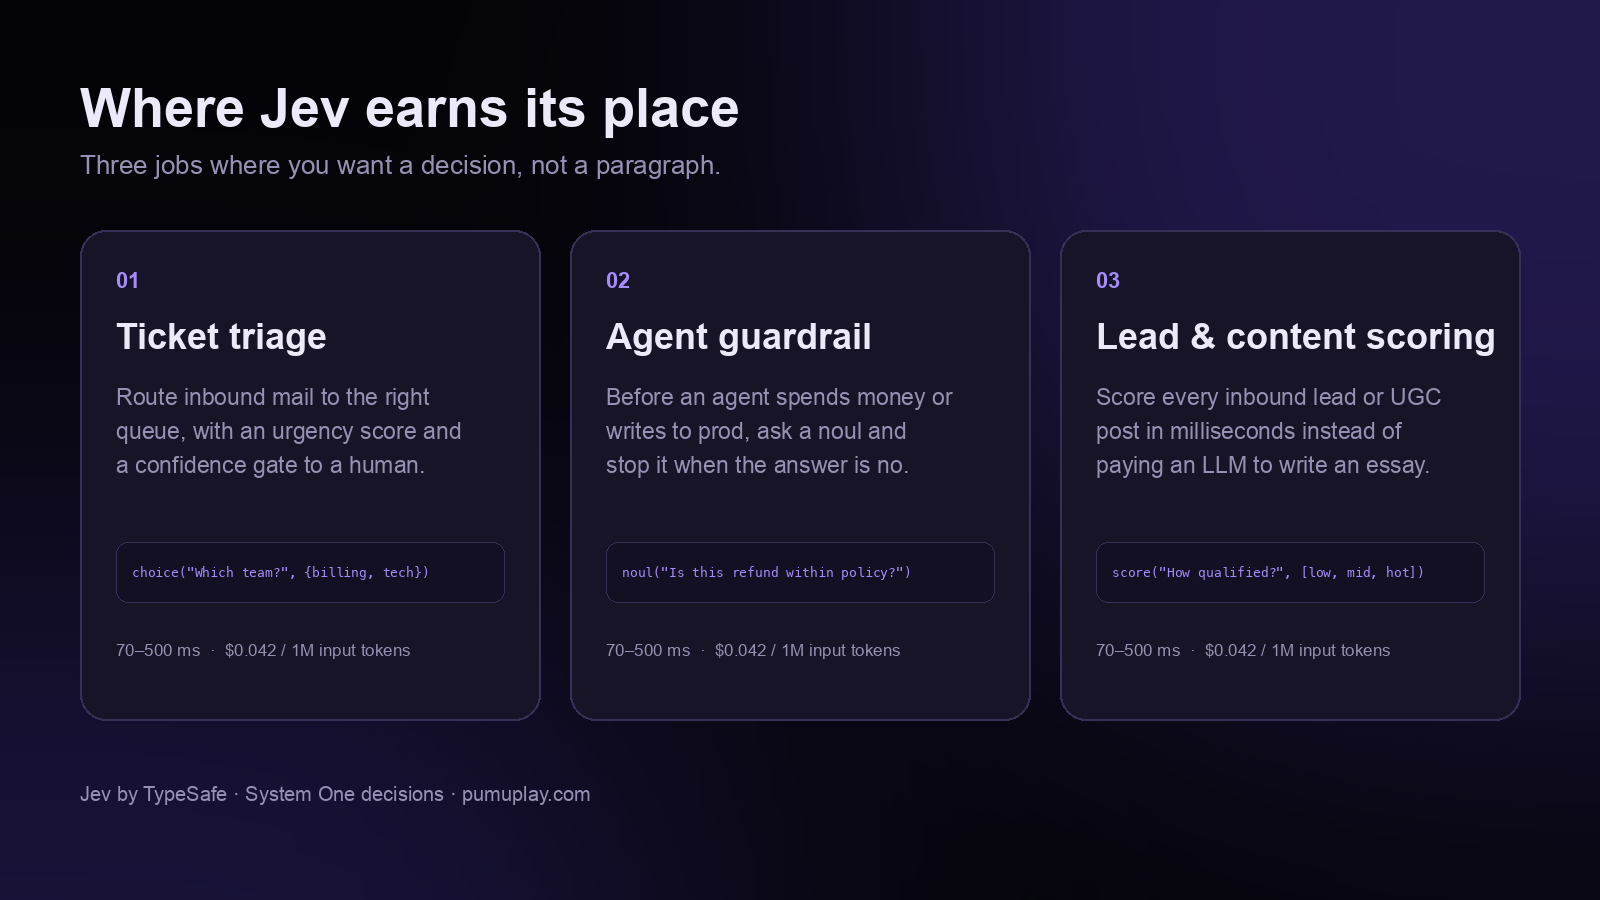
1. คัดแยกและจัดคิว Ticket (Ticket Triage)
เคสคลาสสิกที่สุด: อีเมลหรือแชตเข้ามา → ถามทีเดียวว่า เข้าทีมไหน / ด่วนแค่ไหน / ขอเงินคืนหรือเปล่า → โยนเข้าคิวที่ถูกต้อง
ของแถมที่สำคัญกว่าคำตอบคือ confidence เพราะมันทำให้เราเขียน “ประตูส่งต่อให้คน” ได้แบบตรงไปตรงมา:
const { department } = response;

if (department.confidence < 0.6) {
  await sendToHumanReview({ ticketId, reason: "uncertain_department" });
} else {
  await assignQueue(ticketId, department.choice);
}
นี่คือความต่างจากการให้ LLM ตอบเป็นข้อความ — LLM มั่นใจเท่ากันหมดทุกคำตอบ ส่วน Jev บอกเราว่า “ข้อนี้ไม่ค่อยชัวร์นะ”
2. Guardrail ให้ AI Agent
ถ้าคุณมี agent ที่กดปุ่มจริง (คืนเงิน, ส่งอีเมลหาลูกค้า, เขียนลง production) ให้ใช้ Jev เป็นด่านก่อนลงมือ ถามสั้น ๆ ว่าเข้าเงื่อนไขนโยบายไหม แล้วค่อยปล่อยผ่าน
const { withinPolicy, isHighRisk } = await client.systemOne({
  state: { request: agentPlan, policy: refundPolicy, amount: 12000 },
  questions: {
    withinPolicy: noul("`request` อยู่ในเงื่อนไขของ `policy` หรือไม่?"),
    isHighRisk: noul("`request` นี้เสี่ยงสูงจนต้องให้คนอนุมัติหรือไม่?"),
  },
});

if (!withinPolicy.noul || isHighRisk.noul) return escalateToHuman();
await agent.execute();
ข้อดีคือ guardrail ตัวนี้ทำงานใน ~100 มิลลิวินาที ไม่ทำให้ flow ของ agent ช้าลงจนรู้สึกได้ และถูกพอที่จะเรียกทุกครั้งโดยไม่ต้องคิดมาก
3. ให้คะแนน Lead และคัดกรองคอนเทนต์
ฟอร์มติดต่อเข้ามา 500 รายการต่อวัน ไม่ต้องให้ LLM เขียนสรุปทีละอัน — ถามเป็น score แล้วเรียงลำดับเลย
const { fit, intent, isSpam } = await client.systemOne({
  state: { message: form.message, company: form.company },
  questions: {
    fit: score("บริษัทนี้ตรงกับลูกค้าเป้าหมาย SME แค่ไหน?", ["ไม่ตรง", "พอได้", "ตรงมาก"]),
    intent: score("ความตั้งใจซื้อระดับไหน?", ["แค่ดู ๆ", "กำลังหาข้อมูล", "พร้อมคุยราคา"]),
    isSpam: noul("`message` เป็นสแปมหรือไม่?"),
  },
});
เอา fit.score + intent.score ไปจัดอันดับคิวที่ทีมขายต้องโทรก่อน ส่วน isSpam ตัดทิ้งตั้งแต่ต้นทาง — ทั้งหมดนี้ต้นทุนแทบเป็นศูนย์ต่อรายการ
Error handling: ต้องมีทางหนีเสมอ
โมเดลภายนอกล่มได้เสมอ ฉะนั้นอย่าให้ธุรกิจหยุดตาม:
try {
  const result = await client.systemOne(request);
  // ...
} catch (error) {
  return sendToHumanReview({ ticketId, reason: "model_unavailable" });
}
หลักคิดง่าย ๆ: ค่า default ต้องปลอดภัยเสมอ — ไม่ชัวร์ ส่งให้คน, ระบบล่ม ส่งให้คน
เมื่อไหร่ที่ ไม่ ควรใช้ Jev
- งานเขียนข้อความ — สรุป ร่างอีเมล ตอบลูกค้า ใช้ LLM ตามเดิม Jev ไม่ generate text
- งานที่ต้องคิดหลายขั้น (reasoning) — Jev คือ System One ไม่ใช่ System Two
- งานที่โค้ดคำนวณเองได้ — เลขบวกลบ เงื่อนไขตายตัว regex ง่าย ๆ เขียนโค้ดตรง ๆ ถูกกว่าและแม่นกว่า
ทางที่ดีที่สุดคือ ใช้คู่กัน: ให้ Jev เป็นตัวตัดสินใจและคัดแยกที่หน้าด่าน แล้วส่งเฉพาะเคสที่ต้องใช้ภาษาจริง ๆ ต่อให้ LLM
สรุป
Jev ไม่ได้มาแทน LLM ครับ มันมาแทน “การใช้ LLM ผิดงาน” ต่างหาก
ถ้าในระบบคุณมีจุดที่ต้องถามคำถามซ้ำ ๆ วันละหลายพันครั้ง แล้วต้องการแค่คำตอบสั้น ๆ ที่โค้ดเอาไปใช้ต่อ — นั่นแหละคือจุดที่ Jev คุ้มที่สุด: เร็วระดับหลักร้อยมิลลิวินาที ถูกระดับที่ไม่ต้องกังวล และได้ค่า confidence มาช่วยตัดสินใจว่าเมื่อไหร่ควรส่งต่อให้คน
ที่ PumuPlay เรามองว่านี่คือชิ้นส่วนที่หายไปของระบบ automation สำหรับทีมเล็ก — เพราะงานส่วนใหญ่ที่กินเวลาทีม ไม่ใช่งานเขียน แต่เป็นงาน ตัดสินใจซ้ำ ๆ