- AI
- Claude
- OpenAI
- LLM
Claude Sonnet 5.5 vs GPT-6 Luna และ Opus 5.5 vs GPT-6 Sol: เลือกตัวไหนดี?
เทียบ Claude Sonnet 5.5 กับ GPT-6 Luna และ Claude Opus 5.5 กับ GPT-6 Sol จากราคา ความสามารถ และ benchmark ที่เปิดเผย พร้อมชี้จุดที่ยังไม่มีผลทดสอบแบบเทียบตรง
Claude Sonnet 5.5 vs GPT-6 Luna และ Opus 5.5 vs GPT-6 Sol: เลือกตัวไหนดี?
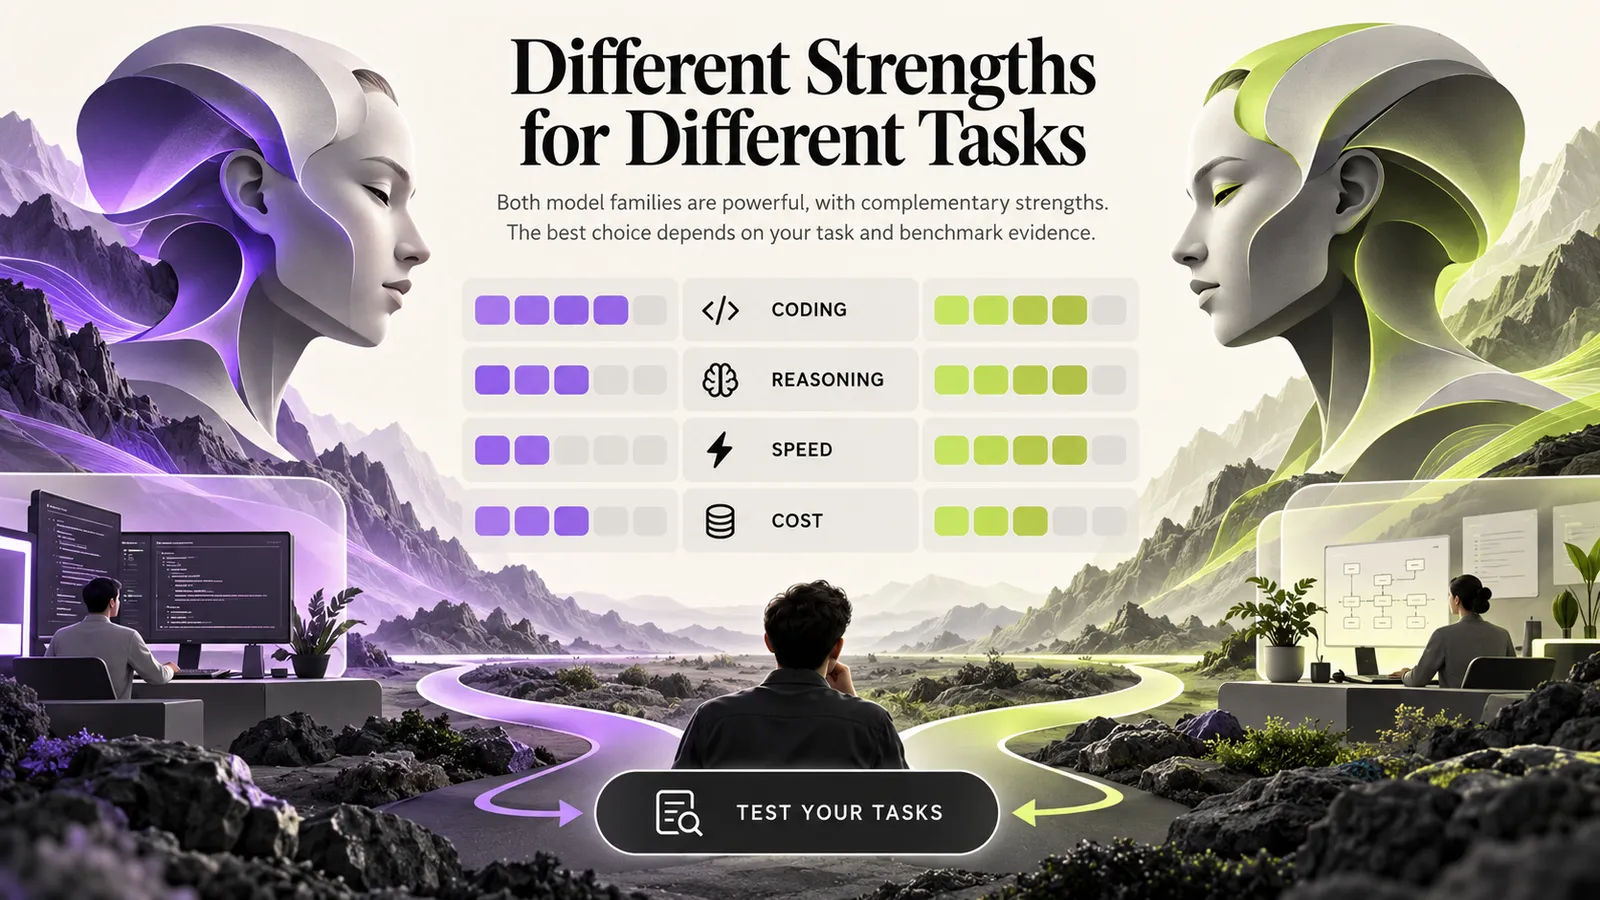
Claude Sonnet 5.5, Claude Opus 5.5 และ GPT-6 Sol กับ GPT-6 Luna ออกแบบมาให้ตอบโจทย์คนละระดับของงาน การดูแค่ชื่อรุ่นหรือราคาต่อ token อาจทำให้เลือกผิดได้ บทความนี้เทียบสองคู่ที่น่าสนใจสำหรับทีมพัฒนาและธุรกิจ: Sonnet 5.5 กับ GPT-6 Luna สำหรับงานปริมาณมาก และ Opus 5.5 กับ GPT-6 Sol สำหรับงานเขียนโค้ดหรือ agent ที่ซับซ้อนขึ้น
ข้อมูลอ้างอิงจากประกาศ Anthropic และเอกสารโมเดล OpenAI ที่เผยแพร่ ณ วันที่ 29 กันยายน 2026 จุดสำคัญคือยังไม่มีผลทดสอบสาธารณะแบบเดียวกันครบทั้งสี่รุ่น: Anthropic รายงาน Sonnet 5.5 เทียบ GPT-6 Sol บาง benchmark แต่ไม่ได้เทียบ Sonnet กับ Luna โดยตรง ส่วนตาราง Opus 5.5 ระบุ GPT-5.6 Sol แทน GPT-6 Sol ดังนั้นอย่าอ่านผลของ GPT-5.6 Sol เสมือนเป็นผลของ GPT-6 Sol
สรุปสเปกและราคา API
ราคาต่อหนึ่งล้าน token สำหรับ API มาตรฐานและ prompt ที่ไม่เกิน 272,000 input token:
| รุ่น | Input | Cached input / cache read | Cache write | Output | Context สูงสุดที่ระบุ |
|---|---|---|---|---|---|
| Claude Sonnet 5.5 | $2 | $0.20 | $2.50 | $10 | 1 ล้าน token* |
| GPT-6 Luna | $0.10 | $0.01 | $0.125 | $0.50 | 1.05 ล้าน token |
| Claude Opus 5.5 | $4 | $0.20 | $5 | $20 | 1 ล้าน token* |
| GPT-6 Sol | $2 | $0.20 | $2.50 | $10 | 1.05 ล้าน token |
* เอกสาร Google Cloud สำหรับ Sonnet 5.5 ระบุ context สูงสุด 1 ล้าน token ส่วนราคา cache ของ Anthropic อ้างจากหน้าประกาศโมเดล
ตัวเลขนี้ทำให้เห็นความต่างของกลุ่มราคาได้ชัด: GPT-6 Luna คิดราคา token ต่ำกว่า Sonnet 5.5 20 เท่า ทั้ง input และ output ส่วน Opus 5.5 มีราคา input และ output สองเท่า ของ GPT-6 Sol ขณะที่ค่า cache read เท่ากัน การใช้ token น้อยหรือมากต่อภารกิจอาจเปลี่ยนค่าใช้จ่ายจริงได้ จึงควรวัดราคาต่องานบน prompt และเครื่องมือของตัวเองด้วย
Sonnet 5.5 vs GPT-6 Luna: งานปริมาณมากหรือคุณภาพต่อรอบ?
Anthropic วาง Sonnet 5.5 สำหรับงานประจำวัน งานโค้ดที่มีขอบเขตชัด และงานเอกสาร โดยระบุว่ารุ่นนี้เร็วกว่า Sonnet 5 มากกว่า 30% และอาจลดต้นทุนต่อภารกิจได้สูงสุด 30% จากการใช้ token น้อยลง ส่วน OpenAI อธิบาย GPT-6 Luna ว่าเป็นรุ่นที่มีประสิทธิภาพสูงสำหรับงานเฉพาะด้านที่มีปริมาณมาก
Sonnet 5.5 มี benchmark เทียบกับ GPT-6 Sol ในประกาศ Anthropic แต่ไม่มีตัวเลข GPT-6 Luna ในชุดเดียวกัน จึงยังตอบจากข้อมูลผู้ผลิตไม่ได้ว่า Luna ทำคะแนนใกล้ Sonnet 5.5 แค่ไหน สำหรับ Luna หลักฐานที่ชัดที่สุดในตอนนี้คือราคาและแนวทางการใช้งานที่ OpenAI ระบุ ไม่ใช่ผล head-to-head กับ Sonnet
เหมาะจะเริ่มทดลอง GPT-6 Luna เมื่อมีงานจำนวนมากที่รูปแบบค่อนข้างซ้ำ เช่น จัดหมวดหมู่ ดึงฟิลด์จากเอกสาร หรือสรุปข้อความสั้น และต้องควบคุมต้นทุนต่อรายการ
เหมาะจะเริ่มทดลอง Sonnet 5.5 เมื่ออยากได้โมเดลราคากลางสำหรับงานหลากหลายกว่า เช่น coding agent, การแก้บั๊กหลายขั้น หรือสร้างเอกสารและสไลด์ ทั้งนี้ควรยืนยันคุณภาพของงานจริง เพราะยังไม่มี benchmark ตรงที่เปรียบเทียบ Sonnet 5.5 กับ Luna ภายใต้เงื่อนไขเดียวกัน
Opus 5.5 vs GPT-6 Sol: งานยากขึ้นและค่าใช้จ่ายสูงขึ้น
ทั้งสองรุ่นมี context window ประมาณหนึ่งล้าน token และรองรับการทำงานผ่านเครื่องมือ แต่ราคา API ของ Opus 5.5 สูงกว่า GPT-6 Sol สองเท่าต่อ token ตามราคาปกติของผู้ให้บริการทั้งสองราย Opus 5.5 จึงต้องสร้างคุณภาพที่ดีขึ้นหรือใช้ token/รอบเครื่องมือน้อยลงพอจะคุ้มกับส่วนต่างนี้
Anthropic รายงานว่า Opus 5.5 ได้คะแนนสูงบน Terminal-Bench 4.0, FrontierCode และ GDPval-AA ส่วนตารางของบริษัทมีผล GPT-5.6 Sol อยู่ด้วย เช่น FrontierCode 47.5% และ GDPval-AA 1588 เทียบกับ Opus 5.5 ที่ 54.4% และ 1846 ตามลำดับ แต่ตัวเลขเหล่านี้เป็นของ GPT-5.6 Sol ไม่ใช่ GPT-6 Sol จึงไม่ใช่คำตอบตรงสำหรับการเทียบคู่นี้
ด้าน Sonnet 5.5 ทาง Anthropic รายงานผล GPT-6 Sol บน FrontierCode ที่ 49.3% และ GDPval-AA ที่ 1487 เทียบกับ Sonnet 5.5 ที่ 46.2% ใน Max หรือ 52.1% ใน Xhigh และ 1844 ตามลำดับ การตั้งค่า effort ต่างกัน และนี่เป็นผลของ Sonnet ไม่ใช่ Opus จึงใช้เป็นข้อมูลข้างเคียงได้ แต่ไม่ควรนำไปสรุปว่า GPT-6 Sol ชนะหรือแพ้ Opus 5.5
สำหรับ Opus 5.5 กับ GPT-6 Sol จึงยังควรตัดสินจากการรันงานชุดเดียวกันจริง โดยเฉพาะ coding agent, งานเรียกเครื่องมือหลายรอบ และงานความรู้ที่ต้องส่งมอบชิ้นงานให้ตรวจได้
เปรียบเทียบตามลักษณะงาน
| ลักษณะงาน | เริ่มทดลองกับ | เหตุผล |
|---|---|---|
| งานซ้ำจำนวนมากและไวต่อต้นทุน | GPT-6 Luna | ราคาต่อ token ต่ำกว่ามากตามรายการ API |
| งานประจำวันและ coding agent ระดับกลาง | Sonnet 5.5 หรือ GPT-6 Sol | ทั้งคู่ราคา $2/$10 ต่อหนึ่งล้าน input/output token; Sonnet มีผลทดสอบของ Anthropic เทียบ GPT-6 Sol ในบาง benchmark |
| งานยากที่ต้องใช้วิจารณญาณและทำหลายขั้น | ทดลอง Opus 5.5 เทียบ GPT-6 Sol บนโจทย์จริง | Opus ถูกวางตำแหน่งสำหรับงานซับซ้อน แต่ราคาต่อ token สูงกว่า 2 เท่า และยังขาด benchmark ตรงจากผู้ผลิต |
| เอกสารยาวหรือบริบทใหญ่ | เทียบทั้งคู่ด้วยชุดเอกสารจริง | ทั้งสี่รุ่นรองรับ context ระดับหนึ่งล้าน token โดยประมาณ แต่ context ยาวไม่ได้รับประกันความแม่นยำเท่ากัน |
วิธีเลือกโดยไม่ยึดกับตารางคะแนนอย่างเดียว
เตรียมตัวอย่างงานจริง 20–50 รายการ แยกตามประเภทและระดับความยาก ใช้ prompt, เครื่องมือ และเงื่อนไขเดียวกัน แล้วบันทึกอย่างน้อยสี่ค่า: งานผ่านเกณฑ์หรือไม่, จำนวนรอบเรียกเครื่องมือ, เวลาเฉลี่ย และค่าใช้จ่ายต่อผลลัพธ์ที่ผ่านเกณฑ์
สำหรับ Luna ให้เช็กอัตราที่ต้องส่งงานต่อให้โมเดลที่เก่งกว่า เพราะราคาถูกมากอาจคุ้มเฉพาะเมื่อผ่านงานได้เอง ส่วน Opus ให้เทียบคุณภาพที่เพิ่มขึ้นกับต้นทุนที่เพิ่มเป็นสองเท่า หากงานต้องแก้ไขต่อโดยคนมากขึ้น ความต่างของราคา token อาจไม่ใช่ต้นทุนหลัก
ข้อสรุป: GPT-6 Luna เป็นตัวเลือกที่น่าทดลองกับงานจำนวนมากที่มีต้นทุนเป็นข้อจำกัด Sonnet 5.5 อยู่ในระดับราคาที่สูงกว่าแต่ผู้ผลิตรายงานผลดีขึ้นบนงานโค้ดและ knowledge work หลายชุด ส่วน Opus 5.5 กับ GPT-6 Sol เป็นการเลือกคุณภาพและวิธีทำงานที่เหมาะกับระบบของทีมมากกว่าเลือกจาก benchmark สาธารณะ เพราะข้อมูลเทียบตรงของคู่นี้ยังไม่ครบ