- AI
- Claude
- LLM
Claude Sonnet 5.5: รุ่นที่เร็วขึ้นและคุ้มขึ้น สำหรับงาน AI ประจำวัน
สรุป Claude Sonnet 5.5 จากประกาศ Anthropic ทั้งความสามารถด้านโค้ดและงานเอกสาร ความเร็ว ราคา benchmark และมาตรการความปลอดภัย พร้อมข้อแนะนำก่อนนำไปใช้จริง
Claude Sonnet 5.5: รุ่นที่เร็วขึ้นและคุ้มขึ้น สำหรับงาน AI ประจำวัน
Anthropic เปิดตัว Claude Sonnet 5.5 เมื่อวันที่ 28 กันยายน 2026 โดยวางตำแหน่งให้เป็นรุ่นที่ทำงานประจำวันได้รวดเร็วและประหยัดกว่า Sonnet 5 เหมาะกับงานเขียนโค้ด แก้บั๊ก ใช้เครื่องมือบนคอมพิวเตอร์ และทำเอกสาร สไลด์ หรือตาราง
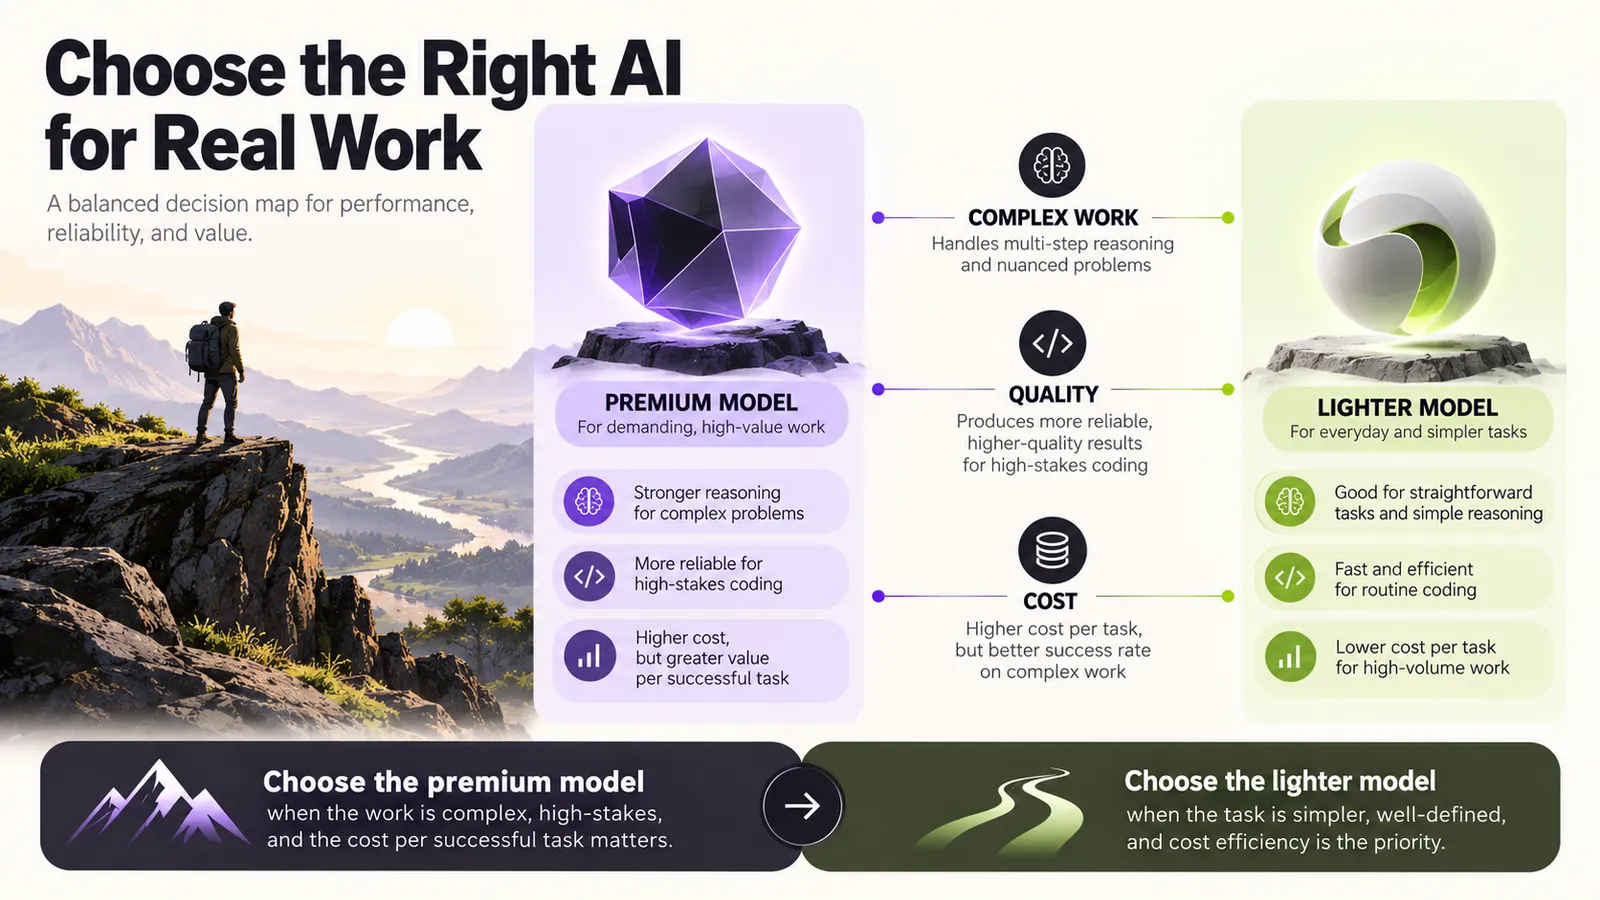
บริษัทแนะนำให้มอง Sonnet 5.5 เป็นตัวเลือกสำหรับงานที่ขอบเขตชัดและต้องทำซ้ำบ่อย ส่วนงานซับซ้อนที่ต้องใช้วิจารณญาณต่อเนื่อง Opus 5.5 ยังเป็นรุ่นที่ Anthropic มองว่าเหมาะกว่า บทความนี้สรุปข้อมูลจากประกาศของ Anthropic และเอกสารแพลตฟอร์ม โดยตัวเลข benchmark เป็นผลที่ผู้ผลิตรายงานเอง ควรใช้เป็นข้อมูลประกอบและทดสอบกับงานจริงก่อนเปลี่ยนระบบ
จุดเด่น: ทำงานเร็วขึ้น ใช้ token น้อยลง
Anthropic ระบุว่า Sonnet 5.5 สร้างคำตอบเร็วกว่า Sonnet 5 มากกว่า 30% และโดยทั่วไปใช้ token น้อยลงเพื่อให้งานเดียวกันเสร็จ บริษัทประเมินว่าค่าใช้จ่ายต่อหนึ่งงานอาจลดลงได้สูงสุด 30% ทั้งนี้ผลจริงขึ้นอยู่กับลักษณะงานและการตั้งค่า effort
ราคาต่อหนึ่งล้าน token เท่ากับ Sonnet 5:
| รายการ | Claude Sonnet 5.5 |
|---|---|
| Input | $2 |
| Output | $10 |
| Cache read | $0.20 |
| Cache write | $2.50 |
ดังนั้นคำว่า “ถูกลง” ในประกาศหมายถึงค่าใช้จ่ายรวมต่อภารกิจที่อาจลดลงจากการใช้ token น้อยลง ไม่ใช่ราคาต่อ token ที่ลดลงโดยตรง
ผลทดสอบที่ Anthropic รายงาน
ประกาศเปิดตัวแสดงผล Sonnet 5.5 เทียบกับ Sonnet 5 และ Opus 5.5 ในการทดสอบหลายประเภท:
| Benchmark | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|
| Terminal-Bench 4.0 (agentic coding) | 70.6% | 10.3% | 66.4%* |
| FrontierCode 1.1 Main (coding) | 46.2% Max / 52.1% Xhigh | 42.4% | 54.4% |
| CursorBench 4.0 (coding) | 55.5% | 34.1% | 57.8% |
| GDPval-AA v2.1 (knowledge work) | 1844 | 1449 | 1846 |
| OSWorld 2.1 (computer use, partial) | 80.1% | 57.0% | 81.8% |
* ผล Opus 5.5 บน Terminal-Bench 4.0 ใช้การตั้งค่า Xhigh ซึ่งเป็นระดับที่ให้คะแนนสูงสุดของรุ่นนั้น
ตัวเลขเหล่านี้ชี้ให้เห็นการพัฒนาจาก Sonnet 5 โดยเฉพาะงานเขียนโค้ดและการใช้คอมพิวเตอร์ อย่างไรก็ตาม ผลทดสอบเปลี่ยนแปลงได้ตาม harness, effort และวิธีคิดคะแนน และ Anthropic เองก็ระบุว่า benchmark สะท้อนความสามารถของโมเดลได้เพียงบางส่วน ตัวอย่างเช่นคะแนน FrontierCode ของ Sonnet 5.5 ต่างกันตามระดับ effort ที่ใช้
งานที่น่าจะเหมาะ
- แก้บั๊กและพัฒนาซอฟต์แวร์: เข้าใจ codebase และทำงานแบบหลายขั้นตอนได้ดีขึ้นตามผลทดสอบและรายงานจากผู้ทดสอบช่วงแรก
- งานเอกสารและวิเคราะห์ข้อมูล: Anthropic รายงานว่าผลบน GDPval-AA ใกล้เคียง Opus 5.5 และยกตัวอย่างการสร้างสไลด์จากเอกสารประกอบธุรกิจ
- งานที่ใช้เครื่องมือ: รองรับ computer use, function calling, web search และ prompt caching บน Google Cloud
- งานที่ต้องทำซ้ำในปริมาณมาก: ความเร็วและการใช้ token ที่ลดลงอาจช่วยลดต้นทุนรวม แต่ควรวัดค่าใช้จ่ายต่อภารกิจจากข้อมูลของทีมเอง
ความปลอดภัยและข้อจำกัด
Anthropic ระบุว่า Sonnet 5.5 มีความสามารถด้าน cybersecurity ใกล้เคียง Opus 5 จึงเพิ่มมาตรการป้องกันแบบเดียวกับโมเดลระดับสูง งานด้านความปลอดภัยไซเบอร์ที่มีความเสี่ยงสูงอาจถูกส่งกลับไปใช้ Sonnet 5 ส่วนการพัฒนาซอฟต์แวร์ทั่วไปยังใช้งานได้ตามปกติ
บริษัทกล่าวด้วยว่า automated behavioral audit พบว่า Sonnet 5.5 ดีขึ้นหรือใกล้เคียง Sonnet 5 ในมาตรวัดส่วนใหญ่ แต่ย้ำว่าการประเมินไม่สามารถตรวจพบความล้มเหลวได้ทุกแบบ จึงควรจำกัดสิทธิ์ของ agent ให้เหมาะกับงาน และตรวจสอบผลก่อนให้ดำเนินการที่มีผลกระทบสูง
สำหรับนักพัฒนา เอกสาร Google Cloud ระบุ context window สูงสุด 1 ล้าน token และ output สูงสุด 128,000 token รุ่นนี้รองรับโหมด thinking ชื่อ between_tools สำหรับกรณีที่ต้องการลด extended thinking โดยยังคงข้อความอัปเดตระหว่างเรียกใช้เครื่องมือไว้
ควรเปลี่ยนมาใช้เลยไหม?
หากใช้งาน Sonnet 5 กับงานโค้ด งานเอกสาร หรือ agent อยู่แล้ว Sonnet 5.5 น่าสนใจสำหรับการทดลองเทียบ เพราะราคา token เท่าเดิม แต่บริษัทระบุว่าเร็วขึ้นและใช้ token น้อยลง เริ่มจากชุดงานจริงที่มีผลลัพธ์ตรวจสอบได้ แล้วเปรียบเทียบคุณภาพ จำนวนรอบเรียกเครื่องมือ เวลา และค่าใช้จ่ายรวม
สำหรับงานที่ผิดพลาดแล้วมีผลกระทบสูง ควรเก็บขั้นตอนตรวจทานโดยมนุษย์ไว้ และไม่ควรใช้คะแนน benchmark เพียงอย่างเดียวเป็นเหตุผลในการย้ายระบบ